При миграции данных ошибка в одном поле может изменить смысл всей записи в новой системе. В этой статье рассмотрим, что такое маппинг данных, как устроено сопоставление source- и target-систем, какие правила нужно зафиксировать и как проверить результат переноса. Вместе с экспертами компании «Анарта» разбираемся с темой переноса бизнес-данных.
Что такое маппинг данных и зачем он нужен при миграции
Для начала давайте разберемся с терминами.
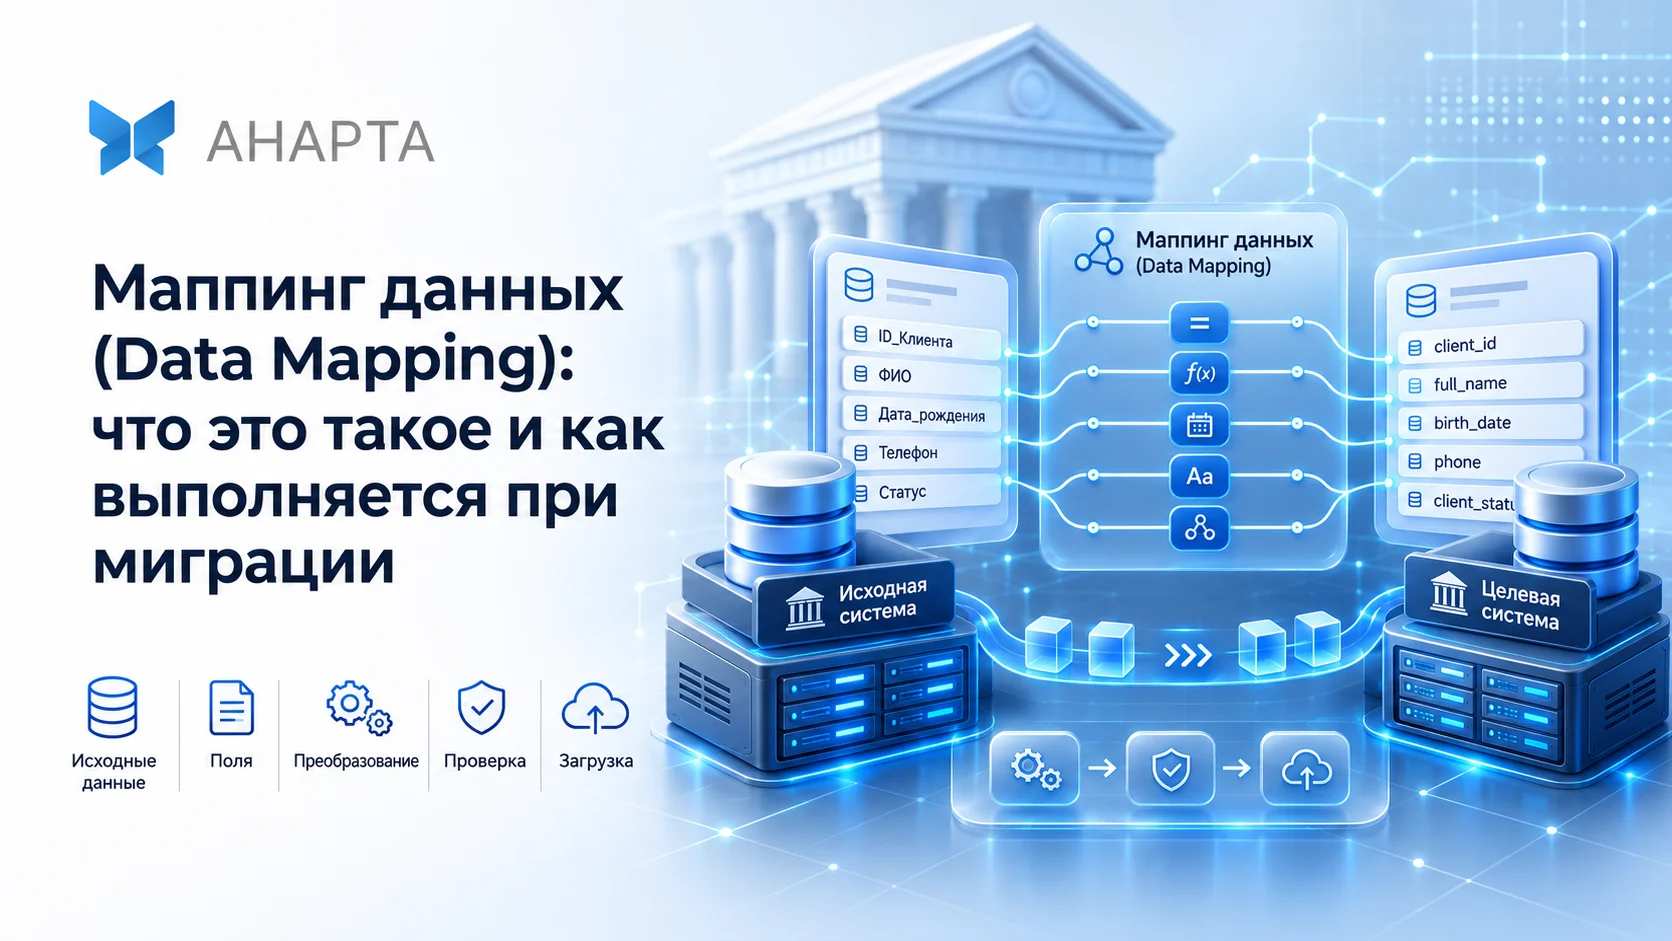
Маппинг данных (Data Mapping) описывает, как информация из исходной системы попадает в целевую. В простейшем варианте это таблица соответствий: поле customer_name из CRM переносится в client_name новой платформы. На практике в описание такой пары включают типы данных, преобразования, обязательность, значения по умолчанию и условия обработки ошибок.
В миграции участвуют как минимум две модели данных. Source содержит исходные таблицы, сущности и поля, а target задаёт структуру, в которую нужно загрузить результат. Между ними редко бывает полное совпадение. Одинаково названные поля могут иметь разный смысл, а одна сущность source иногда раскладывается на несколько объектов target.
Маппинг входит в общий процесс ETL: извлечения, преобразования и загрузки данных. Эксперты «Анарта» по миграции выделяют маппинг и преобразование данных как отдельные работы наряду с анализом источников, тестированием и проверкой качества. Правила маппинга применяются для связи исходной схемы с целевой и могут задавать переименование, префиксы и преобразование типов данных.
Что именно сопоставляют
В зависимости от проекта mapping охватывает несколько уровней:
-
сущности или таблицы: например, «Клиенты» и customers;
-
поля: имя, адрес, статус, дата создания;
-
типы данных: строка, число, дата, логическое значение;
-
значения: коды статусов, валюты, единицы измерения;
-
связи: родительские и дочерние объекты, внешние ключи;
-
правила отбора: какие записи переносить, а какие оставить в архиве.
Автоматическое сопоставление по имени ускоряет подготовку, но не отвечает на вопрос о бизнес-смысле. Поле status = 1 может обозначать активную запись в одной системе и заблокированную в другой. Поэтому итоговые соответствия обязательно подтверждают владельцы данных и предметные эксперты.
Документ маппинга нужен по трем причинам. Он помогает заранее оценить объём работ, делает правила миграции воспроизводимыми и дает основу для проверки результата. Если сопоставление осталось лишь в переписке или в памяти одного специалиста, команда теряет контроль над изменениями и исключениями.
Из чего состоит процесс сопоставления данных
Процесс начинается с инвентаризации. Команда должна понять, какие источники данных задействованы в миграции, какие данные действительно нужны бизнесу и какие ограничения действуют в целевой системе.
Шаг 1. Определить объём миграции
Сначала фиксируют список систем, таблиц, сущностей и периодов, которые входят в проект. Для каждого объекта полезно указать владельца, примерный объём, чувствительность и зависимые записи. На этом же этапе принимают решение о переносе истории: старые данные могут попасть в новую систему полностью, частично или остаться в архиве.
Шаг 2. Сравнить модели source и target
Сопоставление проводят на уровне структуры и смысла. Аналитик данных проверяет названия, типы, обязательность и ограничения полей, а системный аналитик уточняет связи и бизнес-логику. Результат удобно оформлять таблицей:
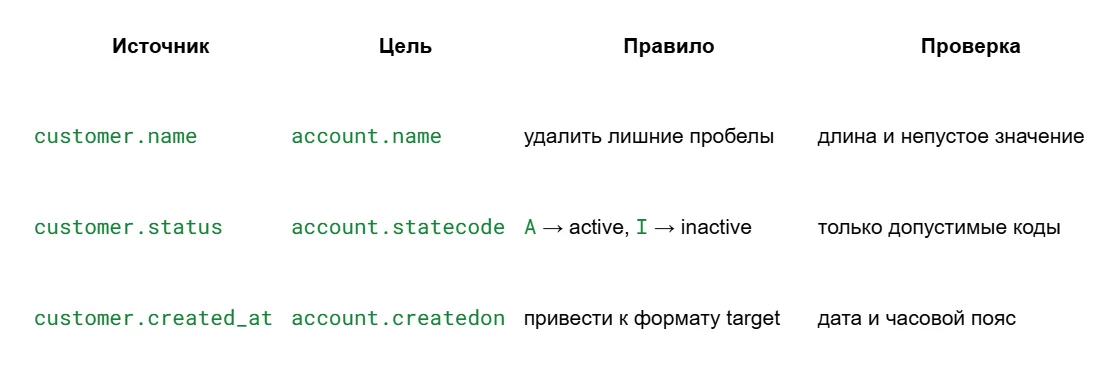
Такой документ показывает, какие поля переносятся напрямую, какие требуют преобразования, а какие исключены с указанием причины.
Шаг 3. Согласовать правила
Правило считается готовым, когда его понимают и техническая команда, и владелец данных. Нужно отдельно обсудить пустые значения, дубликаты, неизвестные коды, даты до определённого периода и записи, не прошедшие проверку.
Mapping-спецификация — рабочий контракт между бизнесом и ИТ. Она отвечает не только на вопрос «куда положить поле», но и на вопрос «что это поле означает».
Шаг 4. Версионировать изменения
В процессе подготовки требования меняются: обнаруживаются новые источники, уточняются статусы, меняются ограничения целевой системы. У каждой версии mapping-спецификации должны быть дата, автор, причина изменения и список затронутых объектов. Иначе команда может столкнуться с непредвиденными последствиями, в лучшем случае — ошибки при миграции данных, в худшем — скрытые ошибки, вызванные неправильным сопоставлением полей. Второй случай опаснее, т.к. последствия сложнее выявить.
Шаг 5. Подготовить тестовый контур
До полной загрузки формируют выборку с обычными и пограничными записями. В неё включают пустые поля, длинные строки, неизвестные статусы, дубликаты и связанные сущности. Такой набор помогает проверить правила и обнаружить ошибки до загрузки всего массива данных.
Специалисты «Анарта» по миграции бизнес-данных рекомендуют учитывать стратегию, последовательность и зависимости миграции, а также заранее определить методы ETL и ответственность команды. Поэтому маппинг лучше рассматривать как управляемый артефакт проекта, а не как временную настройку в интерфейсе инструмента.
Как подготовить правила преобразования и переноса
Правила преобразования позволяют изменить технически совместимые поля так, чтобы данные сохраняли исходный бизнес-смысл. В этой части проекта чаще всего обнаруживаются различия, незаметные при сравнении названий.
Типы данных и форматы
Для каждого поля нужно указать исходный и целевой тип, допустимую длину, точность чисел и правила обработки пустых значений. Отдельного внимания требуют даты и время: одинаковая календарная дата может быть записана в разных часовых поясах или форматах.
Другие типовые преобразования:
-
строка в число с проверкой разделителя и диапазона;
-
несколько исходных полей в одно целевое, например имя и фамилия;
-
одно поле source в несколько полей target;
-
перевод кодов справочника в значения целевой системы;
-
нормализация регистра, пробелов и единиц измерения;
-
вычисление нового значения по бизнес-правилу.
Фрагмент mapping-спецификации с правилами преобразования:
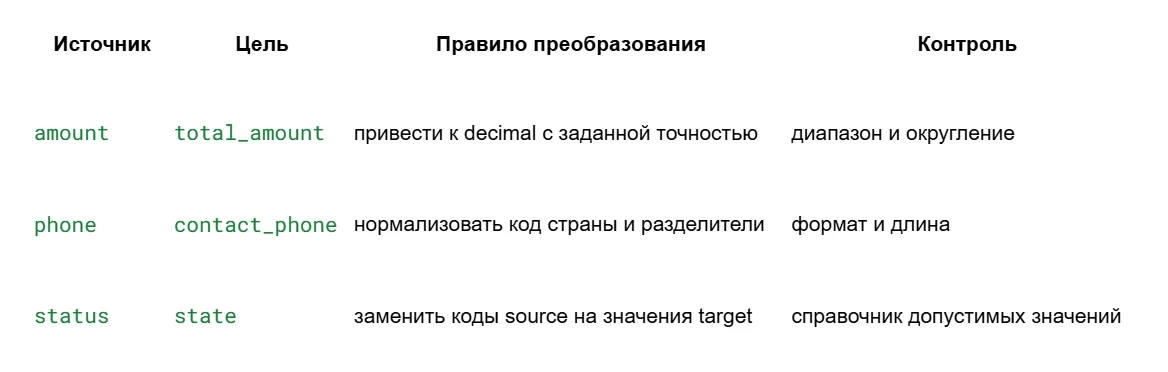
Автоматические средства могут менять типы и структуру схемы. Например, в некоторых правилах преобразования переименовывают схемы, добавляют префиксы и задают преобразование типов. Но поддерживаемые преобразования зависят от конкретной пары источник-цель, поэтому результат автоматической конвертации всё равно следует проверять.
Значения и бизнес-логика
Самая опасная ошибка возникает, когда технически корректное значение получает неверный смысл. Если источник хранит статусы A, I, D, то в маппинге нужно расшифровать каждый код и указать, что произойдёт с неизвестным значением. Такое правило должно иметь владельца со стороны бизнеса. Проще говоря, мы должны понимать, почему вообще существует такое преобразование.
Похожая ситуация возникает с клиентами, товарами и договорами. В одной системе клиент может быть единой сущностью, а в другой — отдельными организациями, контактами и счетами. Здесь недостаточно сопоставить имена полей: нужно описать, как строятся связи и какие записи считаются одной сущностью.
Порядок и зависимости
Зависимые данные загружают после родительских. Сначала могут потребоваться справочники, компании и пользователи, затем товары и клиенты, а после них — заказы, платежи и права доступа. Конкретная последовательность зависит от модели target, но её нужно зафиксировать до запуска.
Исключения и журнал ошибок
У каждого правила должны быть предусмотрены сценарии отказа. Запись можно отклонить, отправить в отдельный журнал или загрузить с признаком, требующим ручной обработки. Если ошибки пропускают без записи, команда получает формально успешную загрузку с неполными данными.
Перед полной миграцией полезно проверить правила на небольшой выборке и вручную проследить несколько цепочек от source до target. Это позволяет обнаружить ошибки в бизнес-логике до масштабирования операции.
Инструменты и роли в проекте маппинга
Инструмент выбирают после описания маппинга, а не вместо него. В простом проекте достаточно таблицы, SQL-запросов и журнала проверок. При большом объёме, регулярных загрузках или сложных преобразованиях используют ETL-платформу, визуальные диаграммы движения данных (mapping data flow) или специализированные средства конвертации схем.
В mapping data flow обычно есть источник, набор преобразований и приёмник данных. Поток поддерживает фильтрацию, соединение, агрегацию, вычисляемые столбцы и просмотр трассировки (lineage) от источника к результату. Эти возможности полезны, когда правила нужно видеть, тестировать и поддерживать как отдельный объект.
Как распределить роли
-
Владелец данных подтверждает смысл, допустимые значения и приоритеты.
-
Бизнес-аналитик описывает процессы и исключения, которые нельзя вывести из схемы.
-
Системный аналитик сопоставляет модели, связи и ограничения target.
-
Инженер данных реализует pipeline, преобразования, журналирование и повторные запуски.
-
Тестировщик проверяет технические результаты и бизнес-сценарии.
-
Руководитель миграции управляет версиями, зависимостями, cutover и согласованием решений.
В небольшом проекте один человек может совмещать несколько ролей, но ответственность за бизнес-правила и техническую реализацию всё равно лучше разделять. Иначе ошибка в предположении останется незамеченной: тот же специалист разработает правило и сам подтвердит его корректность.
Критерии выбора инструмента
При сравнении решений смотрят на:
-
поддерживаемые source и target;
-
работу с типами, справочниками и сложными связями;
-
журнал ошибок и возможность повторной обработки;
-
предварительный просмотр и тестирование выборки;
-
версионирование и трассировку изменений;
-
интеграцию с текущим контуром безопасности и мониторинга.
Название платформы само по себе не гарантирует качества. Важнее, чтобы команда могла объяснить каждое преобразование, увидеть отклонённые записи и повторить загрузку после исправления правила.
Важный момент: очень часто самостоятельная выгрузка и миграция корпоративных данных сопряжена с трудностями, особенно когда речь идет о устаревших legacy-системах. Ваши специалисты могут просто не обладать нужными навыками и квалификацией для надежной миграции. В этом случае, лучше обратиться к профессионалам. «Анарта» занимается миграцией корпоративных данных из legacy-систем, устаревших систем и даже из самописных платформ в современные поддерживаемые решения. При этом все данные, связи и структура сохраняются.
Загрузка и проверка: как контролировать качество результата
Загрузка — этап, на котором ошибки mapping превращаются в операционный риск. Перед запуском нужно выбрать режим работы с target: чистая загрузка, дозагрузка, обновление существующих записей или комбинация полной загрузки с последующим переносом изменений.
Если в целевых таблицах уже есть данные, возможны конфликты ключей и дубликаты. AWS отдельно описывает, как режим подготовки target влияет на задачу миграции: при сохранении существующих данных конфликт может привести к ошибке, а индексы и другие объекты могут потребовать отдельной настройки.
Техническая проверка
После запуска сравнивают не только количество строк. Минимальный набор проверок включает:
-
число прочитанных, загруженных и отклонённых записей;
-
заполненность обязательных полей;
-
уникальность ключей и отсутствие неожиданных дубликатов;
-
корректность типов, диапазонов и допустимых значений;
-
наличие родительских записей для зависимых объектов;
-
список ошибок, предупреждений и записей, отправленных на ручную обработку.
Бизнес-проверка
Техническую сверку дополняют проверкой рабочих сценариев. Пользователь проверяет, что клиент отображается с правильными реквизитами, заказ связан с нужным контрагентом, статус влияет на процесс ожидаемым образом, а история доступна в нужном диапазоне.
Полезно разделить проверки на два контура. SIT (System Integration Testing) подтверждает взаимодействие компонентов и pipeline. UAT (User Acceptance Testing) показывает, может ли бизнес работать с результатом миграции. Для обоих контуров заранее фиксируют критерии приемки и ответственных.
Контроль изменений схемы
Сдвиг схемы (schema drift) возникает, когда источник меняет поля, столбцы или типы уже после проектирования потока. Эксперты «Анарта» предупреждают, что жёстко заданные ETL-паттерны могут не обработать такие изменения, а гибкая схема одновременно уменьшает раннюю проверку имён и типов.
Поэтому проект выбирает один из вариантов: запрещает изменения до согласования, обнаруживает их и останавливает pipeline либо обрабатывает ограниченный набор изменений автоматически. В любом случае нужен мониторинг схемы и тест после изменения источника.
Проверка завершена, когда команда может ответить на три вопроса: всё ли нужное перенесено, не исказились ли значения и можно ли восстановить результат при повторном запуске. Если хотя бы на один вопрос нет подтверждённого ответа, миграция ещё не готова к переключению пользователей.
Типичные сложности и практические рекомендации
Большинство проблем возникает не из-за одной «плохой» строки, а из-за незафиксированного решения. Ниже — практический список для последовательной загрузки и проверки.
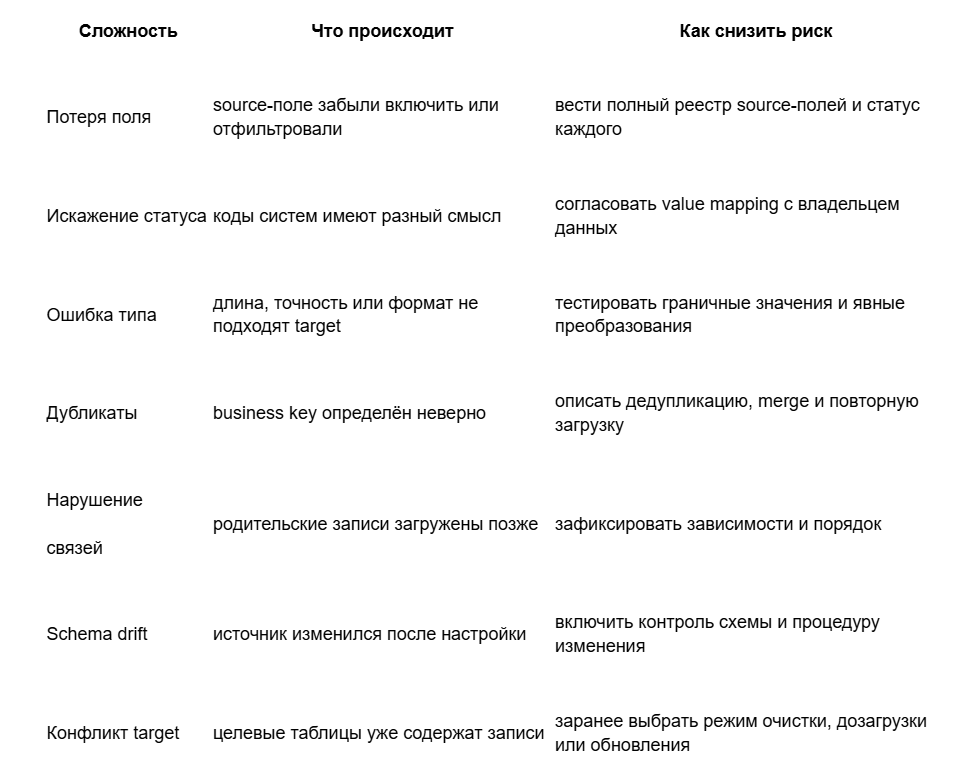
Чек-лист перед стартом
-
Зафиксировать источник, цель и границы набора данных.
-
Согласовать таблицу соответствий с владельцами данных.
-
Описать типы, статусы, пустые значения, фильтры и исключения.
-
Определить бизнес-задачу, дубликаты и правила повторного запуска.
-
Зафиксировать зависимости и порядок загрузки.
-
Подготовить тестовую выборку и критерии SIT/UAT.
-
Проверить режим подготовки цели, резервное копирование и откат.
-
Настроить журнал ошибок, мониторинг схемы и хранение версий mapping.
Этот список не заменяет проектную документацию, но помогает обнаружить пропуски до полной загрузки. Чем раньше команда фиксирует спорные правила, тем меньше исправлений потребуется после переключения пользователей.
FAQ
Что такое маппинг данных?
Data Mapping — описание соответствий между исходной и целевой моделями данных. Документ фиксирует, какие объекты и поля связаны, какие преобразования выполняются и как проверяется результат.
Зачем нужен маппинг при миграции данных?
Он помогает сохранить смысл данных при переходе между разными структурами. Без mapping можно технически загрузить записи, но потерять значения статусов, связи, историю или обязательные поля.
Кто отвечает за составление соответствий между системами?
Техническую реализацию выполняет инженер данных, однако бизнес-смысл правил подтверждают владельцы данных и аналитики. Системный аналитик связывает требования процессов со структурами source и target.
Как проверить качество результата маппинга?
Проверяют объём, обязательные поля, ключи, дубликаты, связи, допустимые значения, ошибки pipeline и рабочие сценарии в SIT/UAT. Одной сверки количества записей недостаточно.
Можно ли выполнить маппинг автоматически?
Инструменты сопоставляют поля по именам и типам, но не подтверждают бизнес-эквивалентность. Статусы, справочники, исторические данные и исключения требуют проверки специалистами.
Что делать при изменении структуры источника?
Нужно обнаружить изменение, оценить его влияние, обновить правила и повторить тестирование. Для динамичных источников применяют контролируемую обработку schema drift, но не отказываются от проверки типов и структуры.
Качественный маппинг данных превращает миграцию из разовой загрузки в управляемый процесс: каждое соответствие имеет владельца, правило, версию и способ проверки. Если нужно оценить исходные структуры, подготовить mapping-спецификацию или спроектировать перенос, команда Anarta может помочь с аналитикой и внедрением решения.